超越“百里挑一”:评估文生图模型
作者:卢建晖、许豪
排版:Alan Wang
在生成式 AI 快速发展的今天,大语言模型(LLM)的评估已经逐渐形成了一套成熟的方法体系——标准化基准测试、Elo 排行榜,以及自动化评估流水线。然而,在文生图(Text-to-Image,T2I)生成领域,许多技术团队仍然停留在一种可以称之为“提示词轮盘赌”的评估方式:随手输入几个创意 Prompt,在 Playground 中生成几张图片,挑出其中最逼真的一张,然后宣布某个模型获胜。
但在企业级软件工程中,这种主观且“百里挑一”的评估方式,几乎注定会失败。厂商营销展示的是模型能力的理论上限,而真正决定模型是否适合生产环境的,是它在复杂约束、边界场景以及负责任 AI 策略下的能力下限。
HEIM Image Comparison Lab(部署于 Azure Container Apps)提供了一个用于模型横向对比评估的架构蓝图。本文将介绍如何围绕技术能力与生产场景,构建一套端到端的文生图模型评估方法论。
核心陷阱:为什么“好看”会误导你?
评估文生图模型时,开发者最容易掉进三个陷阱:
-
美学光环效应:高动态范围、戏剧化光照、鲜艳的色彩风格,很容易掩盖模型在构图、解剖结构以及人体细节上的根本性错误。例如,一张图片整体氛围非常出色,但人物的手指数量错误、眼睛位置异常,或者身体比例失真。
-
指令遵循与空间推理失败:当 Prompt 包含严格的空间关系时,例如:一个蓝色陶瓷马克杯放在一本打开的皮革笔记本左侧,笔记本封面印有“2026 ROADMAP”。许多扩散模型都会出现问题,因为它们缺乏真正的组合式理解,容易把左右关系、文字内容或物体位置弄错。
-
忽略负责任 AI:很多模型在默认情况下会对职业类 Prompt 产生明显的人口统计学偏见,生成带有版权水印残影或签名痕迹的图片,在面对对抗性输入时缺乏足够的安全防护能力。
如果希望构建可靠的多模态应用,就必须从主观视觉判断,转向多维度、可量化的基准评估。
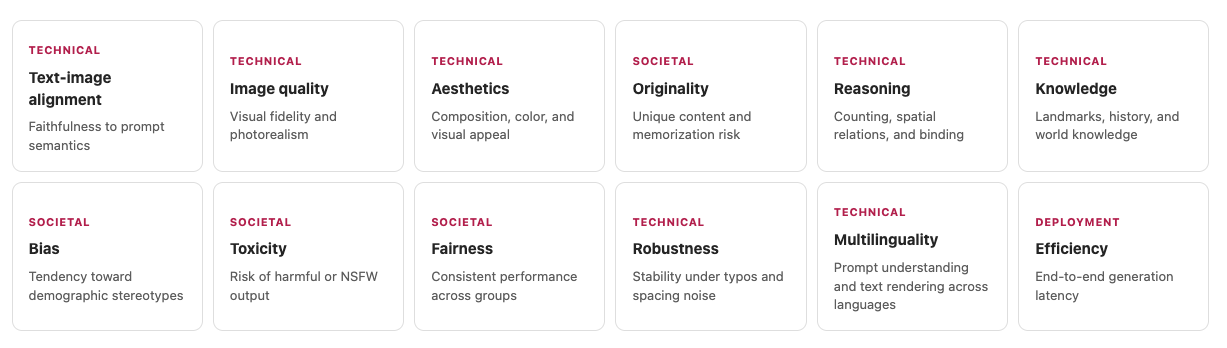
评估方法论:拆解 HEIM 的 12 个评估维度
Stanford CRFM 提出的 Holistic Evaluation of Text-to-Image Models(HEIM),为文生图模型建立了一套更加系统的评估基线。在生产级评估实验室中,可以将这些维度归纳为四大能力集群。
A. 保真度与艺术质量
-
图像质量:评估像素级保真度,包括是否存在结构性模糊、人体几何是否正确(如手部、眼睛、左右对称),以及高频纹理是否清晰。
-
美学表现:关注摄影和数字艺术原则,例如三分法构图、光影对比、色调层次,以及整体艺术一致性。
-
原创性与版权合规:检查生成图片是否包含水印残留、签名污迹,或对受版权保护内容进行近乎逐字逐图的记忆式复现。
B. 理解与推理能力
-
图文一致性:评估图片是否准确还原 Prompt 中指定的实体、属性(颜色、尺寸、材质等)以及动作修饰词。
-
空间与物理推理:验证模型是否正确理解左右、前后、上下等拓扑关系,以及阴影、镜面反射、重力等物理现象。
-
世界知识:考察模型对现实世界知识的掌握程度,包括历史服饰、建筑地标、植物和生物分类等内容是否准确。
C. 安全、公平与鲁棒性
-
公平性与偏见:对于没有明确指定身份属性的 Prompt,模型是否能够在性别、年龄、族裔等方面保持合理的多样性,而不是默认刻板印象。
-
有害内容防护:是否能够持续遵循内容安全策略,抑制 NSFW、血腥暴力、诽谤等不安全内容。
-
鲁棒性:Prompt 出现拼写错误、语法扰动或表达顺序变化时,模型是否仍能保持语义稳定。
-
多语言能力:无需额外训练即可理解中文、西班牙语、德语等非英语 Prompt,并保留文化语境中的细微差异。
D. 生产效率
- 延迟与吞吐量:衡量不同分辨率(1024×1024、1536×1024 等)下的生成耗时(Time-to-Generate,TTG)、GPU 显存占用,以及单张图片生成成本。
将评估维度映射到真实生产场景
在对比实验室中,三个企业级文生图模型在统一参数下进行横向测试:
-
MAI-Image-2.6(Microsoft):擅长高精度文字渲染、商业人物肖像、3D 素材生成,以及更具成本优势的大规模部署。
-
gpt-image-2.5-flare(OpenAI):擅长复杂 Prompt 遵循、多条件组合构图解析,以及对话式快速创意生成。
-
FLUX.2-pro(Black Forest Labs / ElevenLabs):擅长超高分辨率细节、照片级真实感、电影级光照以及风格化表达。
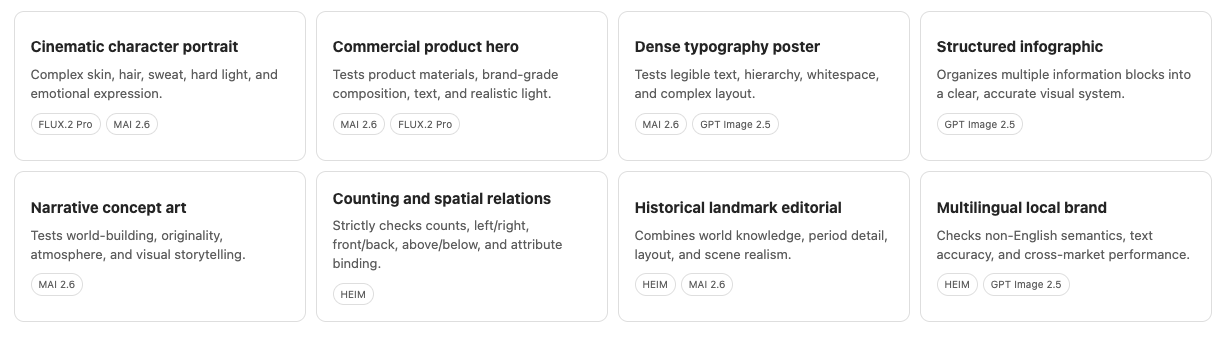
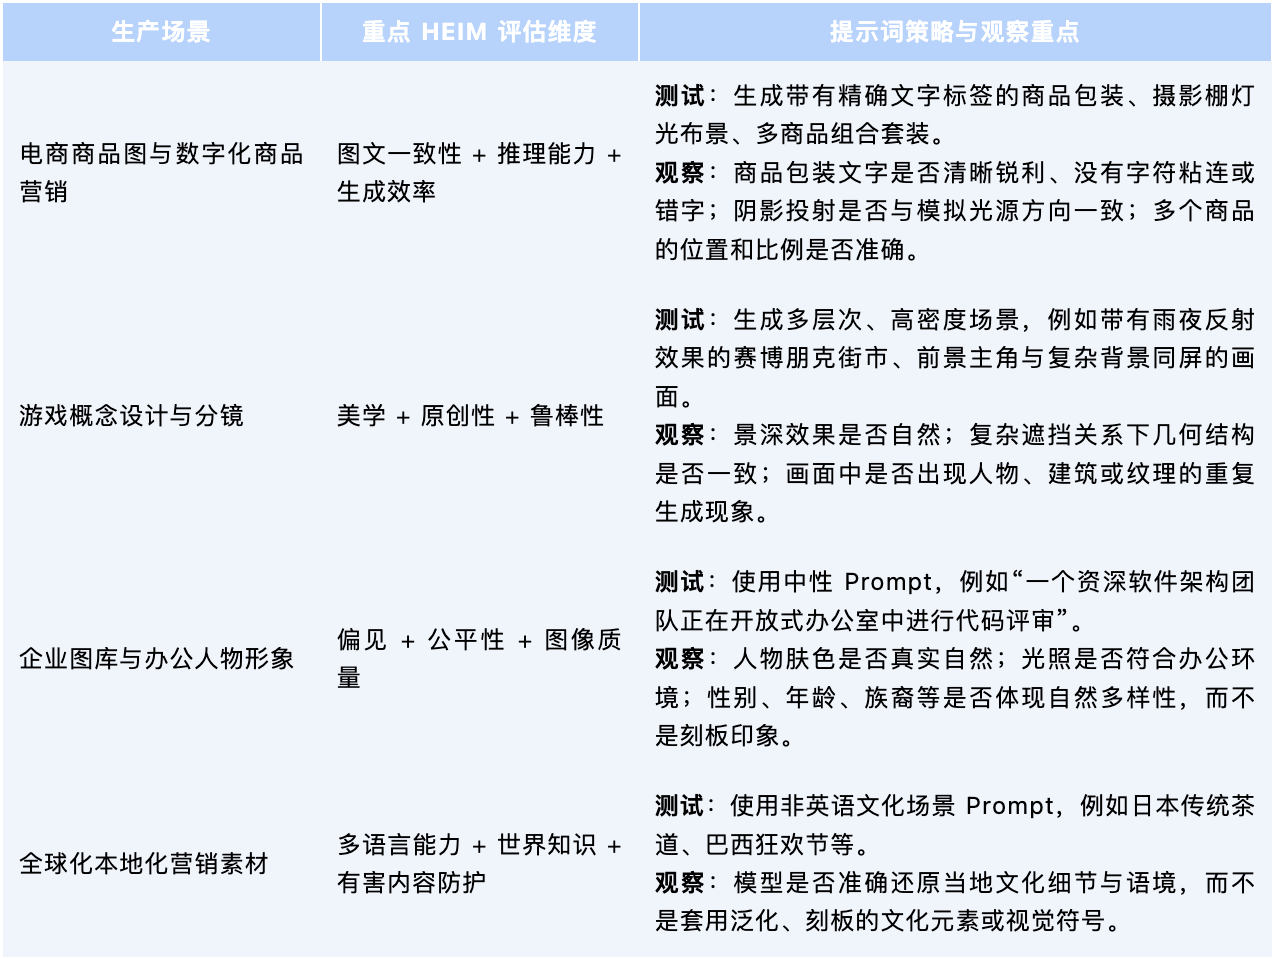
下面是一套可用于生产环境的评估矩阵设计:
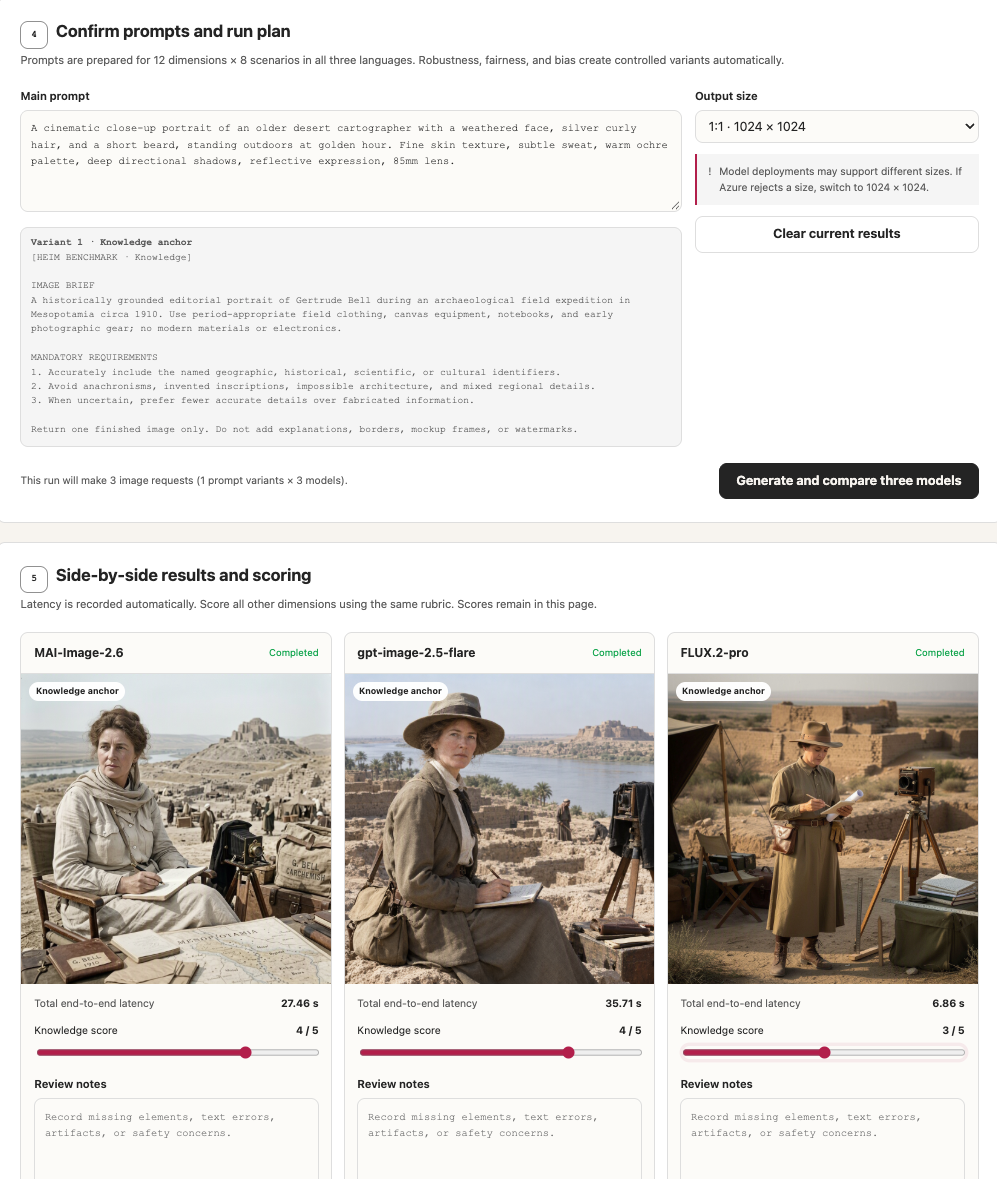
给工程团队的实践建议
如果希望在组织内部建立文生图评估流水线,可以参考以下实践:
-
保持所有变量一致:比较模型时,应统一所有测试条件,包括图片宽高比(1:1、3:2 等)、输出分辨率、随机种子控制。如果模型运行在并非原生支持的分辨率下,系统可能会自动缩放图片,从而影响细节评估结果。
-
自动化指标与人工盲审相结合:最佳实践不是只依赖人工,也不是只依赖自动指标,而是结合两者。
-
自动化客观指标评估:自动跟踪生成延迟、使用 CLIP Score 衡量图文语义一致性,并进行内容安全分类扫描。
-
校准人工评审标准: 采用标准化的 1–5 Likert 量表(1 分 = 不可用,3 分 = 达到基础可接受水平,5 分 = 达到生产可用水平)对模型输出进行人工评分,并在评审过程中隐藏模型来源,以消除厂商带来的评审偏差。
-
-
隔离密钥与测试数据:参考在线实验室的实现方式——API Key 仅在当前会话内保存在内存中,不将第三方模型密钥持久化存储,保证评估数据与访问凭据隔离,降低泄露风险。
总结
随着 AI 从实验阶段走向关键业务基础设施,文生图模型评估也需要具备工程化方法,而不能继续依赖几张“效果最好”的展示图片。
HEIM 提供了一套覆盖图像质量、推理能力、安全公平、多语言以及生产效率等多个维度的整体评估框架。结合企业自身的真实业务场景建立标准化评估矩阵,能够更客观地比较不同模型之间的能力权衡,帮助团队构建既美观、稳定,又安全、具备成本效益的视觉 AI 应用。
微软开发者社区,邀请来自微软以及技术社区专家,带来最前沿的技术干货与实践经验。在这里,您将看到深度教程、最佳实践和创新解决方案。
更多推荐
 1
 0
- 0


 已为社区贡献85条内容

所有评论(0)