技术速递|一份汉堡套餐带给我的智能体启示:Jev、大语言模型与模型路由器
作者:卢建晖
排版:Alan Wang
想象一下,你下班时向 AI 助手提出这样的请求:
“帮我找一家附近的麦当劳,点一份烤鸡腿堡套餐,配中杯可乐。选择到店自取。查一下价格,但不要下单。”
这听起来很简单。然而,对于软件系统来说,这句话至少包含六项决策:选择哪种餐食、购买多少份、选择什么规格、搭配什么饮料、采用哪种取餐方式,以及系统被授权执行到哪一步。
接下来,还有一些现实问题需要解决。哪家餐厅有售?套餐包含哪些商品?优惠券是否适用?最终价格是多少?
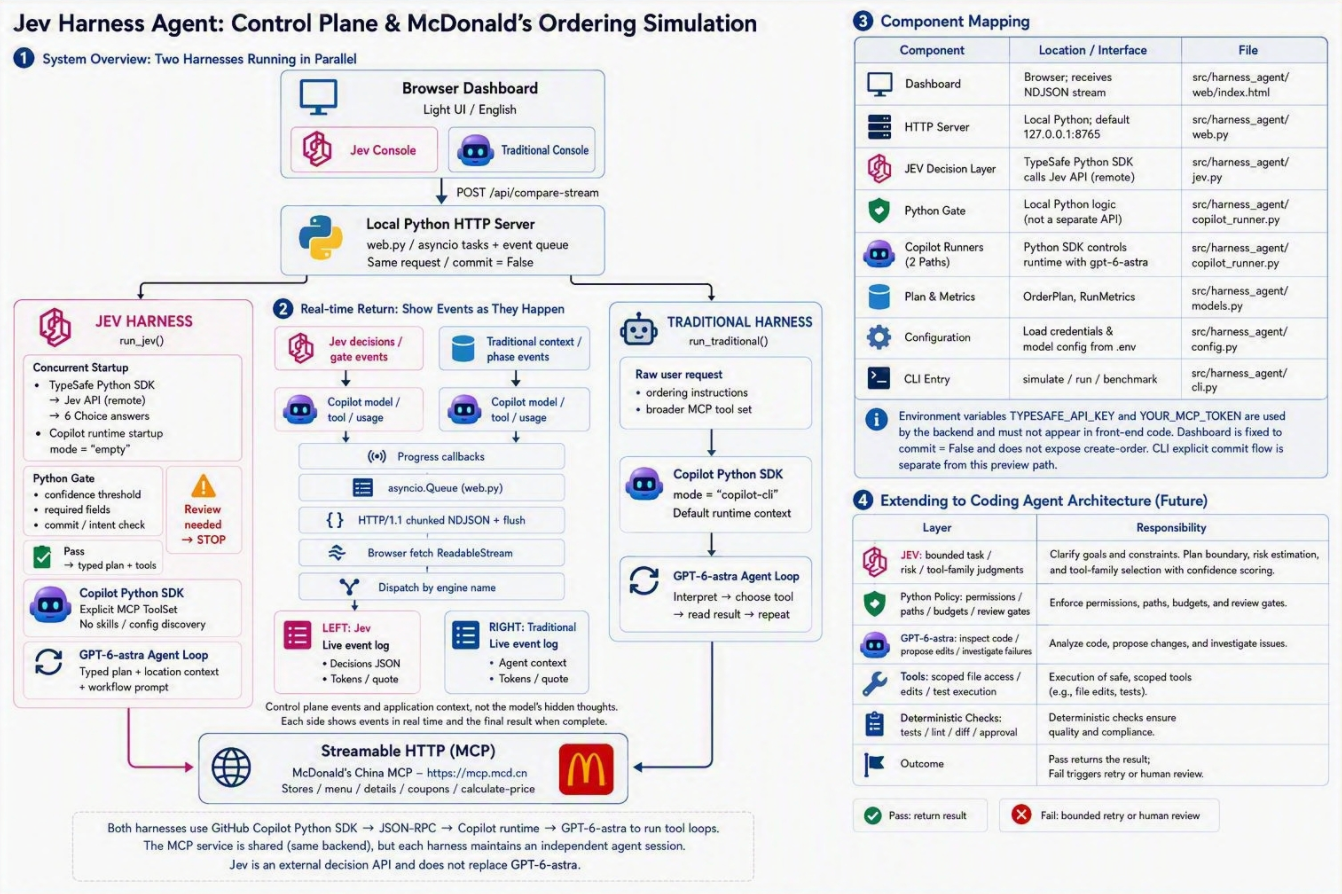
我们围绕这个请求构建了一个小型实验:一个包含两条执行路径的单页应用。左侧是 Jev Harness,右侧是传统的 GitHub Copilot Agent。两者都使用 GitHub Copilot Python SDK 和 gpt-6-astra,并访问同一个麦当劳中国 MCP 服务。
真正值得探讨的问题,并不是哪种 AI 更擅长帮我们点午餐,而是:哪些工作值得交给语言模型处理,哪些工作应该由普通软件明确安排?
1. 传统智能体与大语言模型:厨师不等于餐厅
可以把大语言模型(LLM)想象成一位经验丰富的厨师。
告诉厨师你想吃得清淡一些,他就能理解你的偏好。如果你中途改变主意,他也能灵活调整。这种灵活性很有价值,因为现实世界并不总能被固定的按钮菜单所涵盖。
但仅凭一位厨师,还无法经营一家餐厅。还需要有人负责接单、检查库存、操作收银系统并执行各项规则。
这就是 LLM 与智能体之间的区别。LLM 提供语言理解、推理和生成能力;智能体则是围绕 LLM 构建的系统,能够使用工具并推动任务向前执行。 Harness 提供运行所需的结构,包括上下文、工具访问、执行、反馈和停止条件。
一个典型的工具调用型智能体循环如下:
用户请求 → LLM 选择下一步操作 → Harness 执行工具 → 工具结果加入上下文 → LLM 再次选择下一步 → 结束或重复
这种模式非常强大。例如,编码智能体可以检查失败的测试,找到对应的实现代码,提出修改并再次运行测试。点餐助手则可以查找餐厅、查看菜单并计算报价。
但它也存在一个权衡:厨师可能最终还要处理所有细小的行政决策,例如选择自取还是配送、决定打开哪个工具,以及判断是否需要再次查询。每一轮都涉及模型处理,可能产生更多生成的 Token,还会带来工具调用延迟。随着结果不断累积,对话上下文也会越来越长。
这并不意味着传统智能体天生效率低下。它们同样可以使用结构化输出、受限工具、并行调用和确定性工作流。问题不在于 LLM 不擅长自己的工作,而在于我们有时让同一种执行机制承担整栋大楼里的所有工作。
2. 什么是 Jev?用订单表单代替长篇解释
在 Introducing System One Models & Jev 一文中,TypeSafe 将 Jev 介绍为其首个公开提供的 System One 模型,并以早期访问形式发布。
这个名称借鉴了快速思考与审慎思考之间的区别。你不必将其视为对人类大脑运作方式的字面描述。
更实用的定义是:Jev 接收状态和预先定义的问题,然后返回带有概率信息的类型化决策,而不是自由生成自然语言文本。
回到餐厅的场景。传统 LLM 可以解释为什么某份餐食符合你的偏好。Jev 则更像一位能够理解你所说的话,并在点餐表单中勾选相应选项的接单员。
TypeSafe 提供了三种基本原语: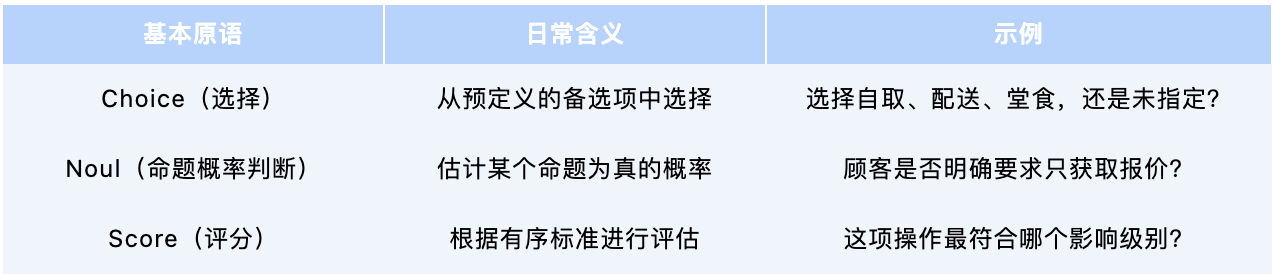
我们的项目只使用 Choice。六个问题被放入一次 system_one 请求中,而不是通过六轮对话逐一询问。根据 TypeSafe 的设计,这些问题会在同一次请求中并行评估。
Choice 的回答包含选定的选项、概率分布和置信度。这几个概念不能混为一谈。概率分布描述不同备选项的概率情况;置信度则是一个独立的确定性指标。置信度为 0.99,并不能证明这笔订单有 99% 的概率完全正确。
TypeSafe 将其训练方法称为校准决策强化学习。其目标是让软件能够更有效地利用模型报告的不确定性。这是一个值得关注的方向,但应用中的阈值仍然需要通过具有代表性的数据进行评估。
同样重要的是,这种方法也有局限性。TypeSafe 的公告强调了类型安全,并使用了“不会产生幻觉”的表述。但工程师应该区分这一说法与绝对可靠的判断能力。
只从菜单中选择,并不意味着一定选中了顾客真正想要的东西。
Jev 仍然可能误解请求。它不是代码生成器,不应该被当作计算器使用,也不能自行授予扣款或部署软件的权限。符合 Schema、语义正确和获得授权,是三个不同的属性。
3. 这与模型路由器有什么区别?
看到这里,一个合理的问题是:“这不就是模型路由吗?”
想象一位餐厅经理需要回答两个不同的问题:
“这道菜应该交给哪位厨师处理?”
“这笔订单是自取还是配送?信息是否完整?现在是否可以继续执行?”
第一个问题类似于模型路由器的职责。第二个问题则更接近 Jev 在本项目中承担的角色。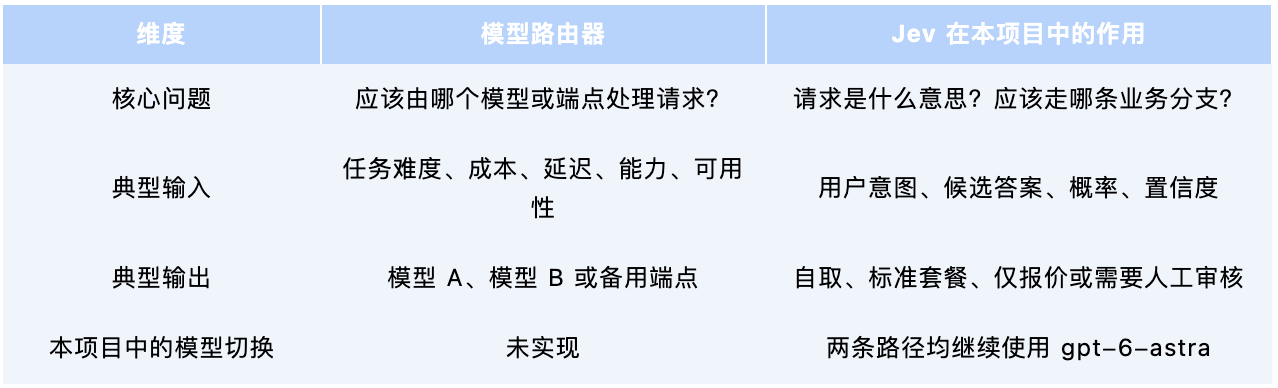
模型路由器是一种架构组件,而 Jev 是一个模型。两者并不属于可以互换的同一类别。
它们也可以协同工作。例如,Jev 可以判断任务的复杂程度,再由路由策略根据这一判断选择合适的模型。应用仍然需要实现模型选择规则、预算管理、可用性检查和故障回退机制。
因此,这个项目并不是在演示如何用一个更快的模型取代 GPT。我们仍然使用 gpt-6-astra。改变的是模型运行之前被分配的工作,以及模型接收到的上下文和工具。
4. Jev 带来的变化:让厨师少处理一些行政事务
最值得关注的变化并不是 JSON 的出现,而是职责分配方式的改变。
传统路径会将自然语言请求直接交给智能体,由智能体负责理解和执行。Jev 路径则会先生成边界明确、可供检查的决策,再由本地代码判断是否可以继续执行,以及应该开放哪些工具。
自然语言请求 → Jev API:生成有界决策和概率 → 本地 Python 门控逻辑:检查阈值、必填字段和权限 → Copilot SDK / Runtime:运行工具调用型智能体循环 → GPT-6-astra + MCP:查询、理解并生成最终回复
Python 门控逻辑既不是独立的 AI API,也不是命令行工具,而是普通的应用程序逻辑。它会检查最低置信度是否达到可配置的阈值(默认值为 0.75),检查取餐方式、餐食和饮料信息是否缺失,并缩小可供智能体使用的工具集合。这个阈值只是演示项目的配置,并不是适用于所有场景的通用安全标准。
Jev 本身通过 TypeSafe Python SDK 调用 API。Copilot Python SDK 则负责控制底层运行时。即使它们使用同一种编程语言,也不意味着这些架构边界就可以被忽略。
对于编码智能体来说,这种职责划分同样有用。“修复这个失败的测试”仍然适合交给能够理解代码并编写补丁的生成式模型。但请求是否只涉及只读操作、是否会修改数据库迁移,或者是否需要使用特定类别的工具,都可以先作为较小的决策进行判断。
随后,代码可以强制执行允许的操作路径、写入权限和必要的检查。模型将某项操作归类为低风险,并不能取代沙箱、授权机制或测试。
这个编码智能体的例子是对该架构的延伸,而不是当前点餐演示中已经实现的功能。该项目目前尚未实现端到端的代码编辑工作流。
还有一点需要注意:当前的 Jev Harness 并没有消除智能体循环。Python 负责执行前置门控和工具过滤,之后,五个工具组成的工作流通过提示词进行描述;GPT-6-astra 仍然负责选择具体的工具调用及其参数。这是一个混合式原型,而不是一个通过代码强制执行每个工作流转换步骤的工作流引擎。
5. 项目实践:追踪一份汉堡套餐在系统中的完整流程
接收订单
我们的场景是:在广州附近的一家麦当劳购买一份烤鸡腿堡套餐,搭配中杯可乐,选择到店自取,只计算价格,不下单。
传统路径直接接收原始请求。Jev 路径则在 src/harness_agent/jev.py 中评估六个 Choice 问题。应用将答案整理成如下形式的订单计划:
{
  "fulfillment": "pickup",
  "meal": "grilled_chicken_combo",
  "size": "regular",
  "drink": "coke",
  "quantity": 1,
  "action": "quote_only"
}
这展示的是编译后的订单计划,并非 API 返回的完整原始响应。
餐食可以从预定义选项中选择,但地点仍然属于开放式文本。我们在实践中才发现这一区别的重要性:如果只传递上述六个字段,执行器就不知道应该去哪里搜索餐厅了。
解决方法并不是让 Jev 凭空编造一个地址,而是保留原始请求,将其作为地点上下文。类型化决策很有用,但这并不意味着我们应该因此丢弃所有非结构化信息。
执行报价查询
通过 Python 门控检查后,自取路径会开放五个 MCP 工具:
query-nearby-stores → query-meals → query-meal-detail → query-store-coupons → calculate-price
这是一个简化的依赖关系示意,并不意味着所有操作都必须严格串行执行。在确定餐厅后,部分菜单查询和优惠券查询可以独立进行。但价格计算仍然依赖实际商品信息和用户选择。
商品标识符、套餐组成和价格均来自 MCP 查询结果,而不是由 Jev 自行编造。在一次成功的执行中,系统找到了烤鸡腿堡、中份薯条和中杯可乐,最终返回的报价为 34.50 元人民币。当时可用的优惠券均不适用,助手也没有为了达到优惠门槛而擅自添加用户不需要的商品。
这是特定时间、特定餐厅的报价,并不代表全国范围内长期固定的价格。
该仪表板没有开放 create-order 工具。因此,这是一项实时查询加模拟购买决策的演示,而不是真正的下单操作。通过 CLI 显式提交订单属于另一项独立能力;本文展示的流程始终停留在报价阶段。
优化性能,并理解为什么最快的一次运行并不算成功
我们最初的设计只是将 Jev 放在现有 Copilot Harness 前面。这并没有神奇地改善整个端到端流程的性能。
原因很简单:接单员虽然已经填写好了表单,但厨师进入厨房时,仍然带着一本厚厚的员工手册、许多无关工具和完整的运行环境。增加一个分类器,并不会自动消除下游执行过程中的额外开销。
随后,我们将 Jev 路径改为 Copilot SDK 的空模式,显式选择需要使用的工具,禁用不必要的技能、会话存储和配置发现,并让运行时启动与 Jev 分类过程并行进行。同时,我们要求系统以简洁的表格形式返回报价。
第一次精简后的运行结果看起来相当出色:耗时约 28.8 秒。但菜单结果被截断了,而且精简后的运行时缺少读取完整输出的工具。因此,系统实际上并没有完成价格计算。
从秒表上看,它赢了;但从用户的目标来看,它失败了。
将较大的菜单结果直接保留在上下文中,才恢复了完整的工作流。这也带来了一种权衡:减少了读取文件的往返次数,却在模型上下文中保留了更多菜单内容。这种方法适用于当前演示,但并不意味着它适用于任意规模的工具返回结果。
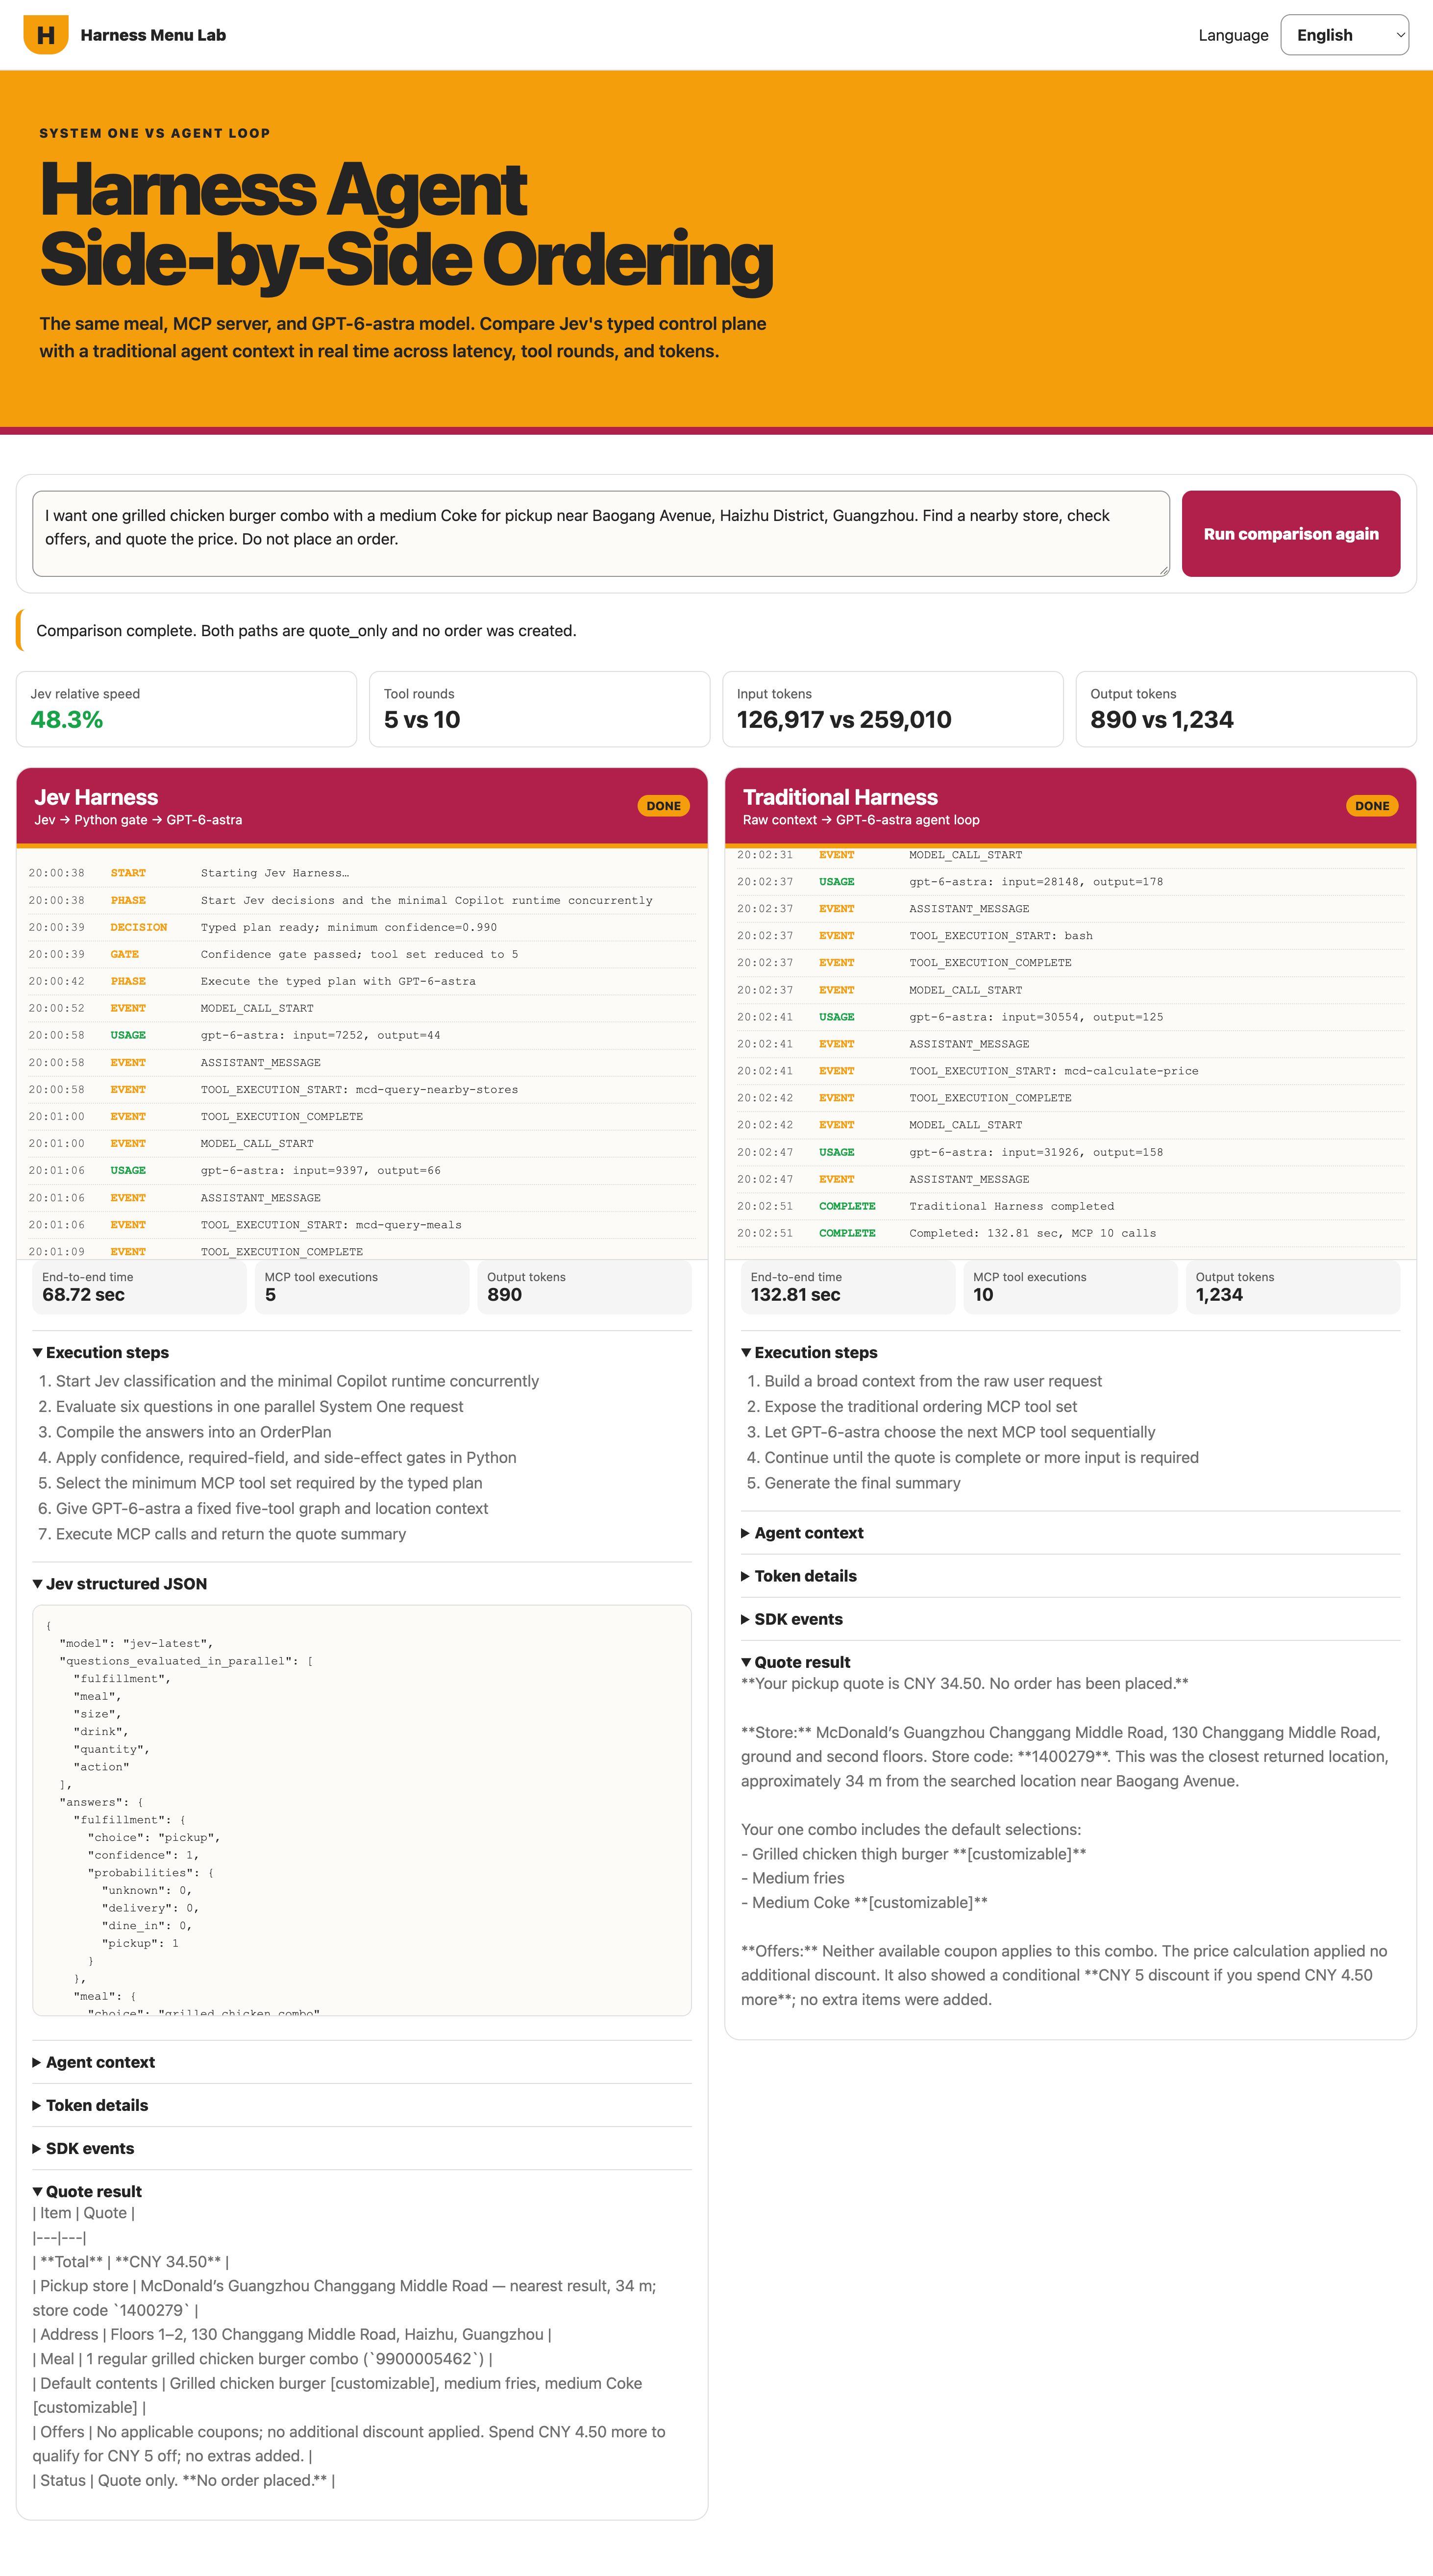
以下是开发控制台输出中的几组独立观测数据。它们并非在固定软件版本上,通过随机化和重复实验得到的基准测试结果。

Jev 路径的数据同时包含 Jev API 和多轮 Copilot 使用所产生的数据。累计输入量包括重复的对话上下文以及与缓存相关的使用量,并不等于文本的唯一长度,也不完全等同于未命中缓存、需要付费的输入量。在缺乏按工具细分的归因数据时,也不应直接将执行启动事件数重新标记为纯粹的 MCP 请求数。
优化后的样本耗时比历史传统路径的样本减少了约 68.7%。但这并不能证明 Jev 本身带来了 68.7% 的性能提升。 两者的运行时配置、上下文、工具、响应长度和服务条件都存在差异。许多优化措施同样可以应用于传统路径。
如果想单独衡量 Jev 的贡献,就需要增加一个同样经过精简、但不使用 Jev 的对照组,并确保两组具有相同的输出要求。随后,重复比较任务成功率、P50/P95 延迟和实际计费情况。
同样,TypeSafe 公告中提到的“快 193.6 倍”和“便宜 444.6 倍”,指的是其特定 System One 工作流评估中的结果。它们既不是本项目的实验结果,也不是对整个餐厅点餐工作流的性能承诺。此外,报告中的 output_tokens 字段是用量指标,并不能证明这些 Token 会按照生成式模型相同的定价规则计费。
观察执行过程,而不只是看秒表
我们构建了一个仅支持浅色主题的仪表板,并提供简体中文、繁体中文和英语三种语言。
点击一个按钮即可同时启动两条执行路径。系统通过分块传输的 NDJSON 将进度事件发送到浏览器。两侧的控制台会实时显示决策阶段、模型调用轮次、工具启动与完成情况,以及使用量事件。结果面板则展示 Jev 的结构化决策、由应用提供给智能体的上下文,以及 Token 详情。
这些内容是可观测的执行事件和应用上下文,并不包含模型的私有推理过程,也不代表 SDK 组装出的全部内部提示词。
安装项目并配置好凭据后,运行以下命令启动:
harness-dashboard
然后打开 http://127.0.0.1:8765。
请将 YOUR_MCP_TOKEN 和 TYPESAFE_API_KEY 保存在本地 .env 文件中,切勿将它们放进浏览器代码或发布的文章里。
并行执行适合用于实时演示,但也会引入网络、速率限制和缓存等因素的影响。要进行严谨的评估,需要固定软件版本、重复运行,并设置明确的成功标准,确认系统确实获得了正确的报价。
如果要从这次汉堡套餐实验中总结一条经验,我会这样说:
让 LLM 处理开放式任务,让 Jev 处理边界明确的判断,让代码负责权限和工作流边界。
更好的智能体不一定拥有更多自主权。有时候,它只是终于学会了如何合理分配工作。
请访问演示项目仓库:
https://github.com/kinfey/jevHarnessAgent
延伸阅读与项目入口
微软开发者社区,邀请来自微软以及技术社区专家,带来最前沿的技术干货与实践经验。在这里,您将看到深度教程、最佳实践和创新解决方案。
更多推荐
 0
 0
- 0


 已为社区贡献91条内容

所有评论(0)